 您当前的位置:
目前全球大模型角逐全面白热化,多强博弈更趋焦灼。竞逐态势的背后是——模型规模扩张、迭代周期加速和架构范式革新。 全球模型性能竞争持续加剧,头部玩家你追我赶。2026年权威评测LMArena数据显示,中美领军厂商呈现交替领跑的贴身缠斗态势。Anthropic凭借Claude旗舰模型连续六个月稳居全球榜首;OpenAI紧追不舍,持续高频迭代GPT系列模型;谷歌发布Gemini4模型、Meta推出Muse系列模型,一起重回竞争牌桌。反观国内,头部AI厂商紧密跟进,在Agentic复杂执行、多模态理解等核心能力维度稳居全球第一梯队;同时阿里千问等国产主力模型已牢固卡位全球开源心智。 更大的参数Scaling与更快的训练迭代,依然是模型摸高智能上限的主轴。模型参数竞争门槛已正式推开10万亿级参数大门,其中Anthropic、OpenAI等海外头部AI厂商旗舰模型已先行迈入这一量级;国内阿里千问与Kimi旗舰模型规模逼近3万亿量级,未来阿里Qwen4.5/5计划迈向5~10万亿。迭代效率上,模型预训练与后训练全流程全面提速,OpenAI、Anthropic等厂商已将迭代周期极限压缩至“1至2个月/版”,国内头部厂商亦以“约2.5个月/版”的高频节奏紧密咬合。 底层架构演进全面深化,驱动“智能×效率”实现协同跃升。当下主流基座已基本定型为“Transformer骨架+注意力机制+MoE稀疏专家”结构,但单纯摸高智能导致算力成本激增,行业转而追求性能成本的平衡最优,并沿两条互补路线演进:一是传统生成式“慢思考”模型继续把推理执行做深做透,借助注意力优化等技术逼近性能前沿;二是全新决策式“快思考”模型——以26年9月行业爆火的Jev模型为代表,主打极致时延与成本,针对边界明确的任务实现毫秒级并行极速判定。未来,快慢思考模型将收敛于统一的智能体框架,各司其职、分层协同:前者复杂快速路由问题的判断,后者承接复杂规划问题的执行。 当全球模型竞争迈入十万亿参数时代,这场“以冲刺速度奔跑的马拉松”迎来资源实力的极限对撞。唯有坚守算力、数据与人才的高强供给,方能牢牢锁定全球牌桌的核心位次。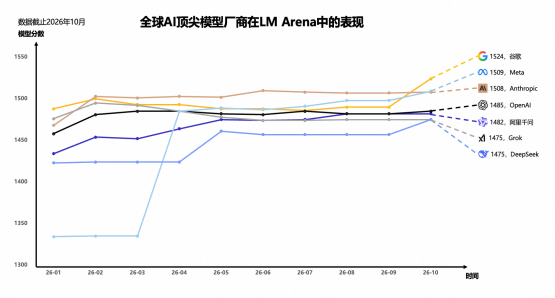
下一波模型能力增量何来?行业共识共同指向了“用AI自主训练AI”的自进化新范式。目前Anthropic内部研发由AI主导的比例已达26%,OpenAI也成功利用AI完成了对GPT-5.6Luna小模型的后训练。
递归自进化(RSI)已成核心探索方向,推动“AI自主训练”全流程落地。RSI旨在彻底打破过往“人搭管线、调算法、洗数据、守集群”的作坊模式,转向由模型主导的全流程自迭代。当前该技术正沿四大支柱纵深突破:一是工程编排,模型自主构建并调度评测验证框架;二是算法探索,通过自博弈深度挖掘架构缺陷并优化训练目标;三是数据工程,实现高质合成数据自生成、清洗与动态评估的完全闭环;四是算力底座,驱动超大规模集群的底层算子优化与故障自愈自治。目前,OpenAI、Anthropic等海外头部厂商已将RSI列为核心战略目标,技术范式正从人工经验驱动向机器自驱动迎来深刻质变。
行业RSI普遍处于L2/L3(AI辅助/协作)阶段,迭代效率正站在倍增临界点。伴随技术加快向L4(AI主导)及L5(完全自主自治)迈进,三重深远的外溢效应正加速释放:其一,持续推升模型规模上限,驱动参数容量加速迈向十万亿级;其二,大幅推高算力消耗,AI海量自博弈试错将对智算底座提出极限考验;其三,促使研发周期极限收敛,实现预训练“2个月/版”、后训练“1个月/版”的高频飞轮。RSI的本质即是挣脱人类智力投入的物理约束,带来全面激活基座模型性能跃升的“二次增长曲线”。
可以预见的是,RSI将成为行业下一阶段的重点发力方向,谁能率先完成端到端“目标-训练-度量-反馈-优化”的生产级RSI闭环,谁就有极大机会手握下一轮模型竞跑的主导权。
以文本为中心的竞赛尚未见顶,战场已全面推向多模态:从“感知理解”到“行动操作”,从“单点生成”至“专业制作”,驱动技术加速驶向全模态统一的新周期。
Agentic能力从文本扩展到多模态,智能体正从“感知世界”走向“亲自做事”。体现在两方面:一是数字世界操作软件,GPT-6、Qwen3.8-Max等已能直接操控Blender、CAD等专业级软件,跑通"设计工程图—渲染3D模型—模拟运行"的完整任务;二是物理世界操控硬件,通过接入行业级硬件标准协议,AI可联动眼镜、机器狗等硬件完成复杂交互任务。这一跃迁的根基,在于训练数据从浅层“单轮问答”转向含反馈的“长程任务轨迹”。尤其在法律、金融等专业领域,行业正将顶尖专家的隐性经验沉淀为高质量决策数据,推动传统低端标注向高阶“专家共创”跃升,并催生了Surge、Mercor等估值超百亿美元的新型数据服务商。
多模态生成加速嵌入制作一线,全模态原生统一方是长期终局。行业研究数据显示,人类辨别AI生成内容准确率仅51.2%,AIGC保真度已迈过商用门槛,正从“单点素材交付”升级为“理解意图的视听生产力”,深度嵌进影视、电商等核心场景。回到技术底层,现阶段的多模态生成仍处于各模态独立分立并行的过渡态。长远来看,将理解、生成与交互彻底收敛于单一大脑的“全模态原生统一”,才是行业演进的必然终局。
多模态AI的技术能力远未抵达天花板。过去以文本代码为中心的推理规划与工具调用能力,正加速迁移到视觉、语音等模态;而全模态理解生成的统一,大概率会从音乐+音频、图像+视频这类“近亲模态”起步,走一条渐进融合的路径。
当AI加速渗透数字世界之际,PhysicalAI引领的物理世界正成为下一个核心主战场。2026年,资本密集涌入、算力与数据百倍扩张、模型能力质变,具身智能已步入爆发拐点。 从"卷身体"转向"卷大脑",具身赛道迎来“数据+算力”需求的百倍扩张。进入2026年,行业重心从“打造健壮身体”转向“打造聪明大脑”。国内近千亿融资涌入该赛道,催生需求爆发式增长:国内专注具身大脑的公司激增至百余家,单家主流厂商的训练算力从百卡迈向万卡、数据从万小时级跃升至百万小时级。虽然路线尚未完全收敛,两大关键信号预示质变临界:一是基座大模型已展现"机器人控制"能力;二是具身领域已出现"看一遍就会做"的泛化能力。正如2020年GPT-3首次展现零样本涌现,具身智能正逼近属于自己的分水岭。 世界模型技术路线尚未收敛,但已成为下一代Physical AI的加速器。世界模型赋予AI对物理规律的内生预测能力,带来双重价值:一是构筑低成本、无限试错的高仿真训练场,让机器人在“物理想象”中预演复杂交互;二是赋予其深刻的物理因果理解与长程规划能力。目前探索路线虽多元并行,但长期演进必将走向收敛统一。放眼长远,它不仅是具身智能的核心底座,更是重塑新一代计算体系的技术范式。国际芯片巨头AMD以82亿美元收购李飞飞创立的WorldLabs,核心意图正是借此锚定模型演进规律,提前布局下一代AI基础设施。 长期来看,具身智能承载着万亿美元级产业规模。谁能率先打通算力、数据等供给底座与制造行业等刚需场景,建立起正向循环的市场机制,谁就能在这场长跑中锁定先发优势。 全球大模型竞逐迈入深水博弈期,智能上限远未见顶。从数字世界迈向物理世界,从人工驱动到RSI自进化,场景应用爆发的根基始终是基座性能。我国唯有长期坚持基础模型性能摸高,筑牢算力数据供给,方可持续托举行业繁荣,牢牢握紧决胜底牌。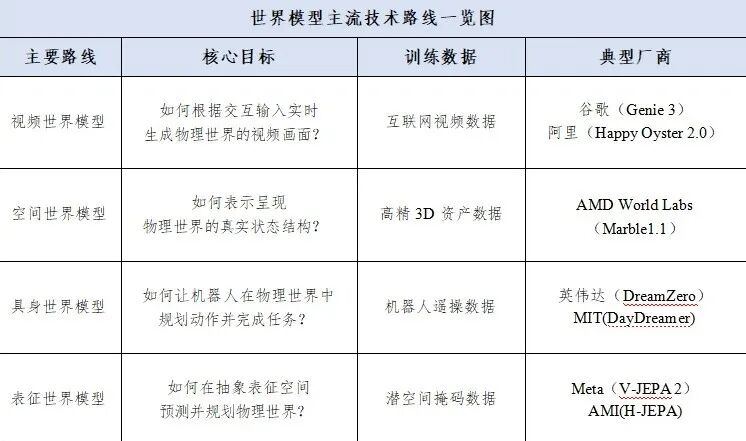
 渝公网安备 50011202502061号
